
ИИ тратит до 180 раз больше энергии на запросы не на английском: что известно об исследовании
Цифры из сниппета 3DNews требуют проверки по первоисточнику
Что произошло
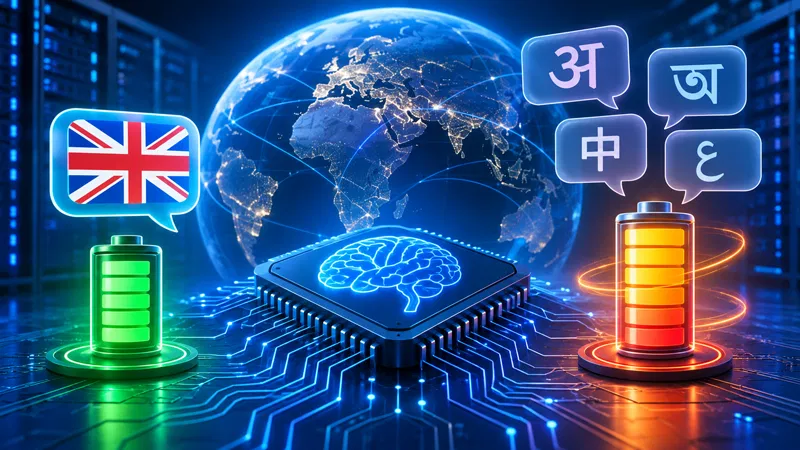
По сообщению 3DNews, исследователи из Мичиганского университета (University of Michigan) показали, что обработка запросов к ИИ-моделям на разных языках требует разного количества энергии. В зависимости от языка и модели энергозатраты на запросы не на английском могут превышать показатели для английского в 1,4–180 раз.
Это важное утверждение, но в переданном фрагменте нет ни названия работы, ни даты публикации, ни списка моделей и языков. Поэтому ниже — только то, что можно аккуратно пересказать, и явно обозначенные пробелы.
Дата события и дата публикации источника
В переданном материале даты не указаны. Нельзя утверждать, когда именно было опубликовано исследование и когда вышел материал 3DNews. Этот пункт нужно уточнить по первоисточнику перед публикацией.
Подтверждённые подробности
Из доступного фрагмента можно выделить только следующее:
Исследование приписывается учёным Мичиганского университета.
Речь идёт о различиях в энергопотреблении при обработке запросов на разных языках.
Диапазон различий обозначен как 1,4–180 раз относительно английского.
Разброс зависит от языка и модели.

Всё остальное — конкретные модели, набор языков, методика измерения, единицы энергии — в переданном фрагменте отсутствует.
Кто затронут
Если выводы подтвердятся, они касаются нескольких групп:
Разработчики ИИ-сервисов, которые обслуживают пользователей на многих языках и платят за вычисления.
Операторы дата-центров, поскольку нагрузка на оборудование и энергосеть зависит от характера запросов.
Компании, закупающие ИИ-инференс, — при мультиязычной аудитории расходы могут различаться сильнее, чем ожидается.
Пользователи не на английском, если разница в затратах когда-либо отразится на тарифах или доступности сервисов.
Практическое значение
Разница в энергозатратах между языками — это в первую очередь вопрос стоимости инференса и планирования нагрузки. Если она действительно достигает десятков и сотен раз, то усреднённые оценки «стоимость одного запроса» могут вводить в заблуждение: для мультиязычного продукта они будут заметно отличаться от реальности.
Однако из одного сообщения нельзя делать вывод о причинах. Возможные объяснения — разная длина токенизированных последовательностей, особенности токенизаторов, качество обучающих данных для конкретного языка — требуют проверки по самой работе.
Что делать пользователю
Для обычного пользователя чат-ботов немедленных действий не требуется: сообщение не содержит данных о том, что сервисы ограничивают или меняют условия для каких-либо языков.
Для команд, которые разрабатывают мультиязычные ИИ-продукты, разумный шаг — не переносить на свои системы цифры из новости, а самостоятельно измерить расход ресурсов на своих языках и моделях. Методика измерения в переданном фрагменте не описана, поэтому воспроизвести её «по мотивам» нельзя.
Что остаётся неизвестным
Название и авторы работы, площадка публикации.
Дата исследования и дата материала 3DNews.
Какие именно модели тестировались.
Полный список языков и соответствие «язык — коэффициент».
Как измерялась энергия: через потребление оборудования, через число токенов или расчётным методом.
Учитывались ли длина запроса и сложность задачи.
Проходила ли работа рецензирование.
Без ответов на эти вопросы цифра «до 180 раз» остаётся утверждением из новостного пересказа, а не проверяемым фактом.
Читайте также
 Чем заменить Nvidia в России: что известно об испытаниях китайских ускорителей и серверов на AMD и Huawei
 Альтман назвал наличие DRAM в домашних ПК «довольно ужасным» и предложил отдать память ИИ-ЦОД
 FDA хочет отозвать одобрение препарата Tavneos: что известно
 Microsoft открыла Windows 11 26H2 для большинства совместимых ПК — что подтверждено
Комментарии
Комментарии доступны только зарегистрированным пользователям. Войти
- Пока нет комментариев. Будьте первым.