
Mercury 3: диффузионная ИИ-модель, которая пишет параллельно и обгоняет GPT-6 Luna по скорости
Почему отказ от последовательной генерации токенов меняет правила игры
Большинство современных больших языковых моделей генерируют текст последовательно, токен за токеном. Такой подход надёжен, но упирается в скорость: чем длиннее ответ, тем больше времени требуется на его создание. Компания Inception из Редвуд-Сити предложила альтернативу — диффузионную большую языковую модель (dLLM) Mercury 3, которая формирует текст иначе и за счёт этого работает заметно быстрее.
Что такое диффузионная языковая модель
В отличие от авторегрессионных моделей, dLLM не выстраивает цепочку токенов строго по одному. Вместо этого она итеративно уточняет сразу весь фрагмент текста, постепенно «проявляя» его из шума — примерно так же, как диффузионные модели работают с изображениями. Для пользователя это означает более высокую пропускную способность при генерации и потенциально иной баланс между качеством и скоростью.
Масштаб и производительность
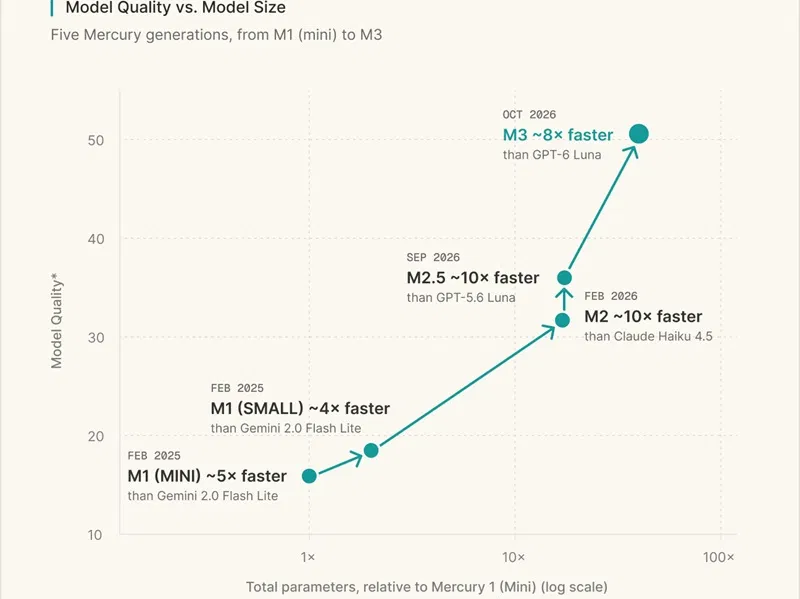
Mercury 3 в 40 раз крупнее своей предшественницы Mercury 1. Несмотря на рост параметров, модель демонстрирует скорость свыше 1000 токенов в секунду. По данным источника, в ряде тестов она превосходит GPT-6 Luna и Claude Haiku 5.5, причём работает в 6–8 раз быстрее них. Это важный сигнал: увеличение размера модели не обязательно должно приводить к замедлению, если архитектура генерации устроена иначе.

Почему скорость имеет значение
Скорость генерации перестаёт быть второстепенной характеристикой. В сценариях, где модель вызывается массово — чат-боты, агенты, автоматизация поддержки, генерация кода в IDE, — задержка напрямую влияет на удобство и стоимость инфраструктуры. Модель, выдающая более тысячи токенов в секунду, способна обслуживать больше запросов на том же железе и делать длинные ответы практически мгновенными для пользователя.
Контекст рынка
Mercury 3 появляется на фоне активной конкуренции между крупными игроками. Сравнения с GPT-6 Luna и Claude Haiku 5.5 показывают, что ниша быстрых и при этом качественных моделей становится всё более значимой. Для разработчиков это означает больше выбора: можно подбирать модель не только по качеству ответов, но и по задержке, пропускной способности и стоимости инференса.
Что остаётся проверить
Заявленные преимущества требуют независимой проверки. Важно понять, на каких именно бенчмарках Mercury 3 опережает конкурентов, как она ведёт себя на длинных контекстах, в рассуждениях и при генерации кода, а также насколько стабильно держит заявленную скорость при реальной нагрузке. Кроме того, открытым остаётся вопрос доступа: будет ли модель доступна через API, какие у неё ограничения и как она поведёт себя в мультиязычных задачах, включая русский язык.
Итог
Mercury 3 — показательный пример того, что конкуренция в области ИИ идёт не только по числу параметров, но и по архитектуре. Диффузионный подход к генерации текста может стать серьёзной альтернативой привычным авторегрессионным моделям там, где критичны скорость и пропускная способность. Если заявленные результаты подтвердятся в независимых тестах, у рынка быстрых языковых моделей появится новый заметный игрок.
Читайте также
 Спутники будут собирать себя сами в космосе: стартап Rendezvous Robotics привлёк $20 миллионов
 ЕС выделит €319 млн на запуск массового производства GaN-чипов на 300-мм пластинах в Австрии
 DeepSeek и Moonshot AI обвинили в дистилляции модели GPT-6 Astra от OpenAI
 С кошельков Binance перевели более $2,7 млрд: биржа проверяет версию о взломе
Комментарии
Комментарии доступны только зарегистрированным пользователям. Войти
- Пока нет комментариев. Будьте первым.