
В суперкластере M**a Prometheus простаивают десятки тысяч ускорителей NVIDIA — в ожидании отказа рабочих чипов
Резервные GPU как часть стратегии отказоустойчивости гиперскейлера
Масштаб проблемы
Суперкластер Ma Prometheus в Нью-Олбани (штат Огайо) — один из крупнейших вычислительных проектов компании. По данным The Register, ссылающегося на информацию самой Ma, более 11 % установленных ИИ-ускорителей либо уже вышли из строя, либо простаивают в ожидании, когда откажет ещё один из активных чипов. Речь идёт о десятках тысяч устройств.
Что такое Prometheus
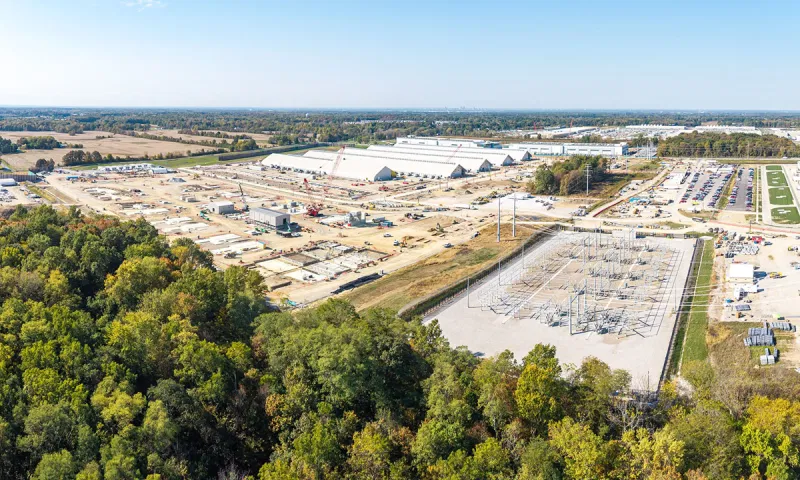
Комплекс построен на стоечных системах Grace Blackwell, а в перспективе получит и решения Vera Rubin. M**a рассчитывает масштабировать Prometheus до 1 ГВт мощности с использованием порядка миллиона ускорителей. На таких масштабах даже небольшой процент отказов превращается в заметный парк неработающего оборудования.
Зачем держать чипы в резерве
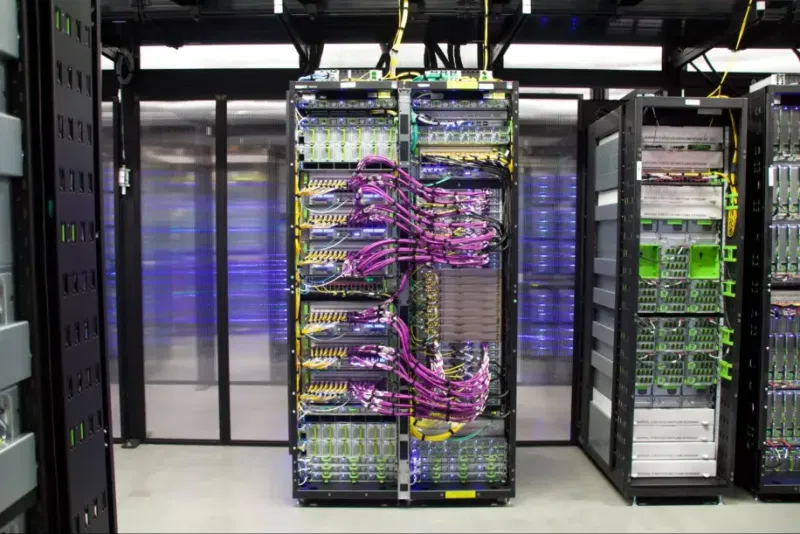
Обучение крупных ИИ-моделей — процесс длительный и дорогостоящий: простой из-за вышедшего из строя ускорителя может сорвать целые этапы тренировки. Поэтому гиперскейлер заранее держит пул запасных чипов, готовых заменить отказавшие. Такой резерв — лишь одна из мер обеспечения бесперебойности, о которых сообщает компания.
Инженерная цена надёжности
Содержание «горячего» резерва означает, что часть дорогостоящего железа не приносит полезной вычислительной работы. Фактически это страховка: гиперскейлер платит за простой, чтобы не платить за простой обучения. На фоне гонки за масштабом ИИ-инфраструктуры такая практика показывает, насколько сложно поддерживать стабильность на кластерах из сотен тысяч ускорителей.

Контекст отрасли
Случай Prometheus иллюстрирует общий вызов для всех, кто строит ИИ-суперкластеры: надёжность отдельных компонентов не растёт так же быстро, как их количество в стойке. Чем больше чипов, тем выше вероятность отказа в любой момент времени — и тем важнее архитектура резервирования и мониторинга.

Что это значит для рынка
Для поставщиков ускорителей подобные истории — сигнал, что спрос на железо частично формируется не только обучением, но и необходимостью замены. Для заказчиков — напоминание, что заявленная мощность кластера и его полезная мощность могут заметно различаться.
Итог
Prometheus показывает, как гиперскейлеры балансируют между масштабом и надёжностью: часть ускорителей неизбежно простаивает, но именно этот резерв позволяет не останавливать обучение. Насколько такая стратегия экономически оправдана при переходе к гигаваттным кластерам — вопрос, на который ответит только практика эксплуатации.
Читайте также



Комментарии
Комментарии доступны только зарегистрированным пользователям. Войти
- Пока нет комментариев. Будьте первым.